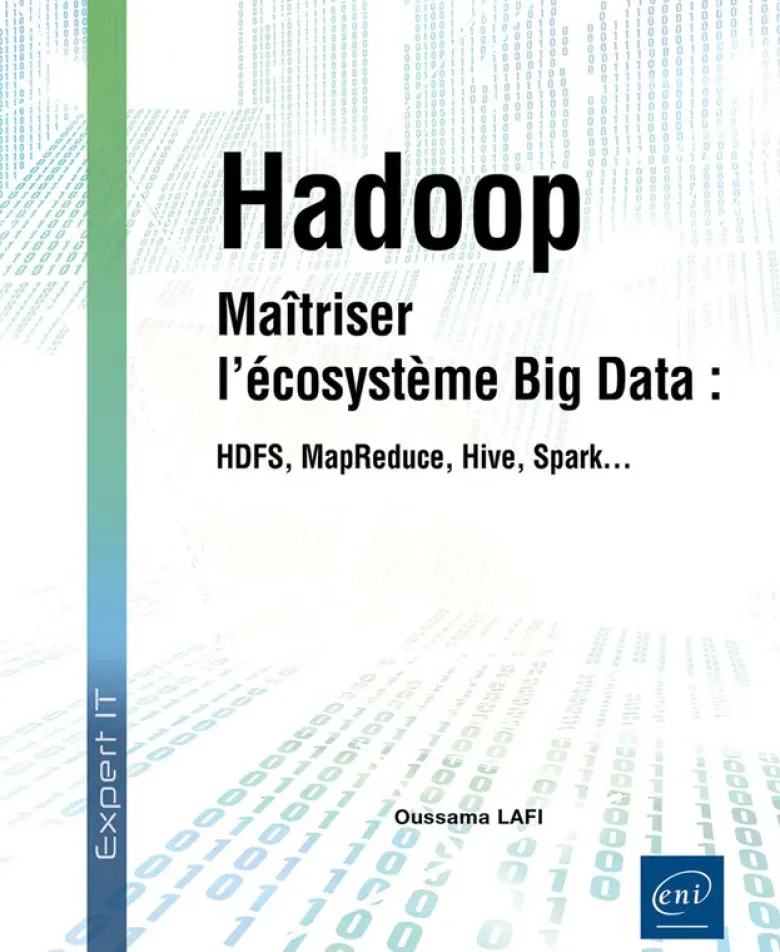
Hadoop – Maîtriser l’écosystème Big Data : HDFS, MapReduce, Hive, Spark…
€27.51
Présentation
LeBig Data occupe aujourd’hui une place centrale dans les architectures décisionnelles modernes. Hadoopen est l’un des piliers historiques et demeure une technologie incontournable pour comprendre les fondements du stockage massif et du traitement distribué de donnéesà grande échelle.
Pensé aussi bien pour les débutants que pour les professionnels souhaitant structurer leurs connaissances, cet ouvrage propose un parcours progressif, clair et structuré, qui accompagne le lecteur depuis les bases du Big Data jusqu’à la réalisation de projets concrets avec Hadoop. Après une introduction aux enjeux du Big Data et à la genèse d’Hadoop, le livre détaille l’architecture du framework, son fonctionnement interne et ses briques fondamentales : HDFS, YARN et MapReduce.
Le lecteur est guidé pas à pas dans l’installation d’un cluster Hadoopen local, puis dans la manipulation du système de fichiers distribué HDFSà travers des commandes, des exemples pratiques et des scénarios proches des environnements professionnels. Les premiers traitements MapReduce en Pythonpermettent ensuite de comprendre en profondeur la logique du calcul distribué.
L’ouvrage ouvre également sur l’écosystème Hadoop moderne avec Hive, Pig, Spark, HBase, Sqoop, Oozie, ainsi que les outils d’ingestion, d’orchestration et de gouvernance. Enfin, plusieurs chapitres sont consacrés à des projets Big Data complets, offrant une approche méthodologique, des bonnes pratiques et des cas d’usage concrets.
Caractéristiques
| EAN13 | 9782409054303 |
|---|---|
| ISBN | 978-2-409-05430-3 |
| Éditeur | Éditions ENI |
| Date de publication | 12 mai 2026 |
| Collection | Expert IT |
| Nombre de pages | 583 |
| Dimensions | 21,6 x 17,8 x 3 cm |
| Poids | 930g |
| Langue | français |
| Fiches UNIMARC | S’identifier |
Be the first to review “Hadoop – Maîtriser l’écosystème Big Data : HDFS, MapReduce, Hive, Spark…”
Related products
Livres
Livres
Bretagne
Livres
Écologie Et Nature
Livres
Littératures De L'Imaginaire
Littérature Et Essais Littéraires
Livres
Bretagne
Livres
Féminismes Et Lgbt++
Reviews
There are no reviews yet.